
Introduction
Deux approches principales permettent de traiter les étapes de transfert et de gestion des poids du modèle, le prétraitement et la structuration des données d’entrée et le calcul des tenseurs et des fonctions d’activation, sous contraintes de latence et de consommation énergétique.
La première approche repose sur l’utilisation d’un processeur généraliste (CPU) capable de séquencer les opérations successives : chargement des poids en mémoire cache, application des transformations aux données d’entrée, puis exécution séquentielle des produits matrice-vecteur et des non-linéarités associées. Dans certains cas, le CPU peut être épaulé par un coprocesseur spécialisé, tel qu’une unité vectorielle (SIMD) ou un NPU (Neural Processing Unit), permettant d’accélérer le calcul d’inférence. Cette approche est communément désignée sous le terme Edge AI computing. Les latences typiques se situent dans un ordre de grandeur allant de quelques centaines de microsecondes à quelques centaines de millisecondes, dépendant de la profondeur du modèle, de la taille des tenseurs et de la fréquence d’horloge du CPU. Dans des scénarios optimisés (par ex. modèles compressés ou quantifiés), des latences de l’ordre de 100 µs peuvent être obtenues.
La seconde approche repose sur l’utilisation d’architectures spatiales câblées, reposant sur une granularité fine du calcul distribuée directement dans la matrice logique d’un FPGA ou dans des blocs spécifiques d’un ASIC. Ces architectures exploitent la disponibilité de ressources matérielles spécialisées telles que les DSP48 (multiplicateurs-accumulateurs), les BRAM (mémoires embarquées à accès rapide) et les LUT (Lookup Tables pour la logique combinatoire). Contrairement à l’approche CPU séquentielle, le paradigme spatial permet d’instancier en parallèle autant d’unités de calcul que nécessaire pour couvrir une ou plusieurs couches du modèle. Cette stratégie, souvent désignée comme Spatial Accelerators, permet d’obtenir des latences extrêmement faibles, typiquement de l’ordre de quelques centaines de nanosecondes pour une opération de convolution ou une étape de multiplication matrice-vecteur. De plus, en fonction de l’empreinte mémoire du modèle (nombre de poids, taille des buffers intermédiaires), il est possible d’implémenter plusieurs modèles d’inférence en parallèle dans un même composant FPGA, ouvrant la voie à des architectures multi-modèles embarquées pour le traitement simultané de flux de données pour capteurs multiples.
Cette distinction est cruciale pour les applications de traitement du signal en environnements contraints : les architectures CPU/NPU offrent une grande flexibilité algorithmique mais avec des temps de réponse plus élevés, tandis que les accélérateurs spatiaux optimisent la latence et la déterminisme temporel, caractéristiques essentielles pour le traitement au plus près du capteur (edge sensing).
Comparaison
Pour comprendre les avantages et les inconvénients de chaque matériel pour inférer un modèle d’IA, nous avons construit des modèles basés sur une problématique triviale. Il s’agit de déterminer la région d’appartenance de coordonnées (x,y)
dans un plan à deux dimensions. La forme des régions est de plus en plus complexe engendrant un MLP de plus en plus profond. Les données et les modèles sont codés en python. Le tableau ci-dessous décrit donc les différents modèles appelés challenge.
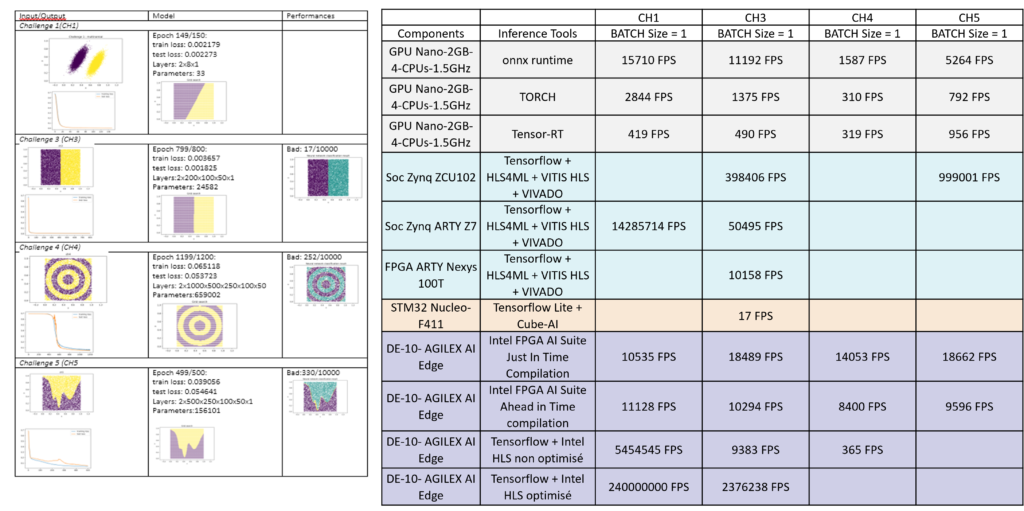
En utilisant les challenges ci-dessus avec les frameworks disponibles pour des composants GPU Nano, des System On Chip Zynq et Agilex et un processeur STM32, nous obtenons des vitesses d’exécutions permettant le traitement de N entrées par secondes (Frame per second). Les résultats sont présentés dans le tableau ci-dessus également. On constate que plus le réseau est petit, plus le nombre de FPS est important. Si le composant possède beaucoup de ressources (DSP et LUT), la latence est faible. Un simple processeur ne peut pas rivaliser avec des architectures spécialisées comme les FPGA et GPU. Pour les GPU, si on regroupe les données d’entrées sous forme de matrices —2000 x 2 (X,Y) —, on améliore drastiquement le nombre de FPS comme le montre le tableau suivant.
En analysant l’ensemble des paramètres d’inférences des divers composants, la facilité d’utilisation des frameworks d’optimisation des modèles et les ressources utilisées, on peut établir des critères de sélection qualitatifs pour le choix des composants suivant le temps de latence (ou FPS) spécifié. Une liste de ces critères et leur définition est établi ci-dessous.
Adaptabilité : Facilité à changer, faire évoluer le modèle dans le système embarqué.
Puissance de calcul : Fréquence de base maximale pour réaliser un calcul élémentaire.
Latence ou FPS : Temps moyen d’obtention du resultat d’inférence à partir d’une instance des données d’entrée du modèle.
Flux de données : Rapidité avec laquelle on peut fournir les données d’entrées pour chaque calcul d’inférence.
Parallélisme : Moyen disponible pour réaliser les calculs internes du modèle en parallèle et améliorer la latence.
Puissance consommée : Puissance consommée lors d’un calcul d’inférence du modèle.
Facilité d’implémentation : Facilité d’utilisation des outils d’optimisation du modèle fourni avec le composant cible.
Densité de modèle : Nombre de modèle inféré pouvant s’exécuter en parallèle de façon indépendante.
Complexité : Complexité d’inférence du modèle selon la cible matérielle.
On peut alors établir qualitativement les avantages et les inconvénients des composants cibles pour réaliser l’inférence dans un système embarqué. Nous utiliserons les termes de « High » pour désigner une force, « Mean » pour désigner un aspect neutre et « Low » pour designer une faiblesse. Le tableau ci-dessous résume alors les avantages des composants cibles étudiés.
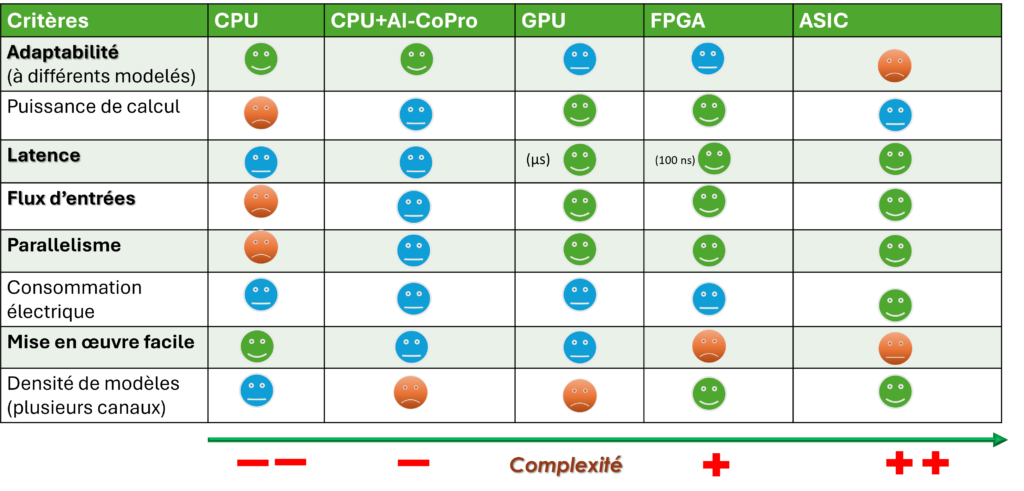
Selon le taux d’évènement de l’application, les critères permettent de choisir la cible pour l’inférence et de travailler sur les optimisations du modèle suivant la méthodologie décrite au §III pour que le modèle puisse être inféré sur la cible.