
Introduction
Les méthodes d’inférence issues de l’intelligence artificielle visent à approximer une fonction , paramétrée par un vecteur , à partir d’un ensemble de données d’entrée-sortie . L’objectif est de déterminer θ de manière à minimiser une fonction objectif (fonction de perte).
où ℓ(⋅,⋅) est une mesure d’erreur adaptée à la tâche considérée (par exemple l’erreur quadratique moyenne pour une régression, ou la fonction log-vraisemblance négative pour une classification).
L’optimisation de est réalisée via la descente de gradient :
où η>0 est le taux d’apprentissage. L’efficacité de cette méthode repose sur l’algorithme de rétro-propagation, qui permet un calcul efficace des gradients en exploitant la structure hiérarchique du modèle. Un neurone élémentaire est défini comme la composition d’une transformation affine et d’une fonction d’activation non linéaire :
| Partie Affine | Fonction d’activation | |
où est la matrice des poids, le biais, et une fonction non linéaire (sigmoïde, ReLU, tanh, etc.).
En empilant plusieurs couches, on définit un réseau de neurones profond :
où L est la profondeur du réseau, et les paramètres du réseau.
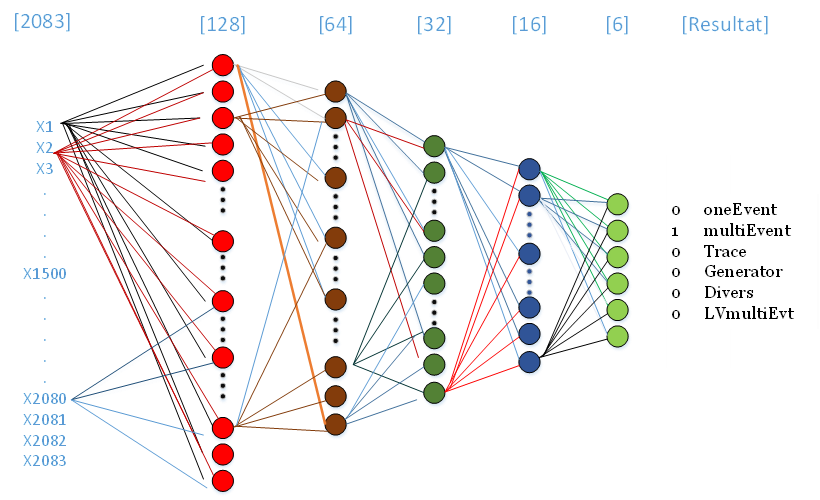
Ainsi, l’inférence correspond à l’évaluation de pour de nouvelles entrées, tandis que l’apprentissage consiste à résoudre le problème d’optimisation :
Une fois la phase d’apprentissage achevée, les paramètres optimaux du modèle — appelés poids et biais pour un réseau de L couches — sont figés. Le déploiement consiste alors à appliquer la fonction d’inférence
,
aux nouvelles données d’entrée , de manière à produire une sortie correspondant à la décision recherchée (classification, régression, détection d’événements, etc.). Différentes familles de modèles existent, chacune adaptée à une structure particulière des données :
- Réseaux de neurones convolutionnels (CNNs) pour des signaux structurés (images, séries temporelles),
- Réseaux récurrents (RNNs, LSTMs, GRUs) pour le traitement séquentiel,
- Réseaux liquides (LNNs) pour des dynamiques non linéaires à temps continu,
- Transformers pour la modélisation de dépendances longues portées.
Le choix du modèle relève donc d’un compromis entre :
- Expressivité (capacité d’approximation),
- Complexité algorithmique ,
- Coût en ressources matérielles .
En pratique, cette sélection reste largement empirique, suivant une démarche d’exploration par essai-erreur :
sous contraintes , où est la fonction de perte mesurée sur un jeu de validation, et l’espace des modèles candidats (ex. CNN 1D, ResNet, YOLO, etc.). Des architectures établies — telles que ResNet50 pour la classification d’images ou YOLO pour la détection d’objets — sont intégrées aux bibliothèques open-source et servent de points de référence. La problématique centrale en déploiement devient alors une optimisation bi-critère :
- Minimiser le temps d’inférence ,
- Minimiser la consommation de ressources (mémoire embarquée, DSP, LUTs sur FPGA).
Formellement, on cherche :
Maintenant, la problématique est d’optimiser la quantité et la rapidité des calculs à effectuer pour obtenir une réponse à partir des données d’entrées.